百聆模型家族再添新成员 BayLing-Duplex,一个面向实时语音交互的原生全双工语音语言模型(SpeechLM)。
相比传统“用户说完,系统再回答”的轮次式语音大模型,BayLing-Duplex 希望让模型更接近真实对话:它可以一边听用户说话,一边生成语音回复;当用户中途打断时,模型能够及时停止当前回答,并根据新的输入继续对话。
论文:https://arxiv.org/abs/2606.14528
代码:https://github.com/BayLing-Models/BayLing-Duplex
模型:https://huggingface.co/BayLing-Models/BayLing-Duplex
为什么需要全双工语音对话?
现有语音对话系统大多仍按“用户说一轮、助手答一轮”的方式工作:系统通常依赖语音活动检测模块(VAD)先判断用户是否说完,再把这段语音交给模型生成回复。即使支持用户打断,也往往是外部系统先停止播报,再把新的用户输入作为下一轮请求处理。
但真实对话是连续的。用户可能停顿、补充,也可能在助手说话时插入新的问题。我们希望模型不只是被动接收一段段切好的语音,而是在说话的同时继续听用户输入,并自己判断什么时候该开口、什么时候该停下、什么时候该转向新的问题。
这正是 BayLing-Duplex 要解决的问题:让“听、说、停”成为语音大模型自身的生成能力,而不是依赖外部轮次判断模块。
BayLing-Duplex
BayLing-Duplex 的核心思路,是将用户输入、模型回复和交互状态统一表示为 token 序列,并交由语音大模型以自回归方式建模。这样,接话、保持沉默、停止回复、被打断后继续回答等行为,都可以转化为模型自身的 next-token prediction 问题,从而充分复用现有语音大模型的理解与生成能力。
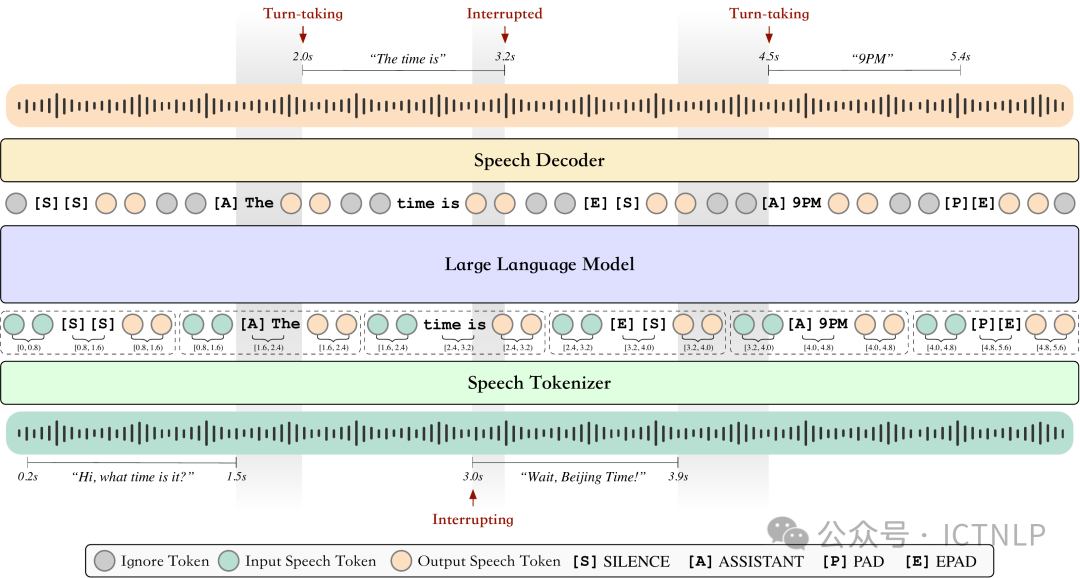
具体来说,BayLing-Duplex 在开源语音语言模型 GLM-4-Voice 的基础上构建,并将全双工对话表示为三条交错通道:
●用户语音通道:持续接收用户输入;
●助手文本通道:作为模型的内部文本规划;
●助手语音通道:生成最终播放给用户的语音。
在具体实现上,对话状态 token 负责标记模型当前的交互状态,例如保持沉默、开始回复、继续输出语音或结束当前回复。模型在生成这些状态 token 的同时,也生成对应的文本和语音 token,从而在同一套序列建模框架中完成接话、停止和被打断后的重新回答。
因此,BayLing-Duplex 不需要额外的决策分类器或外部状态机,也不需要为全双工交互重新设计一套模型架构;它可以直接复用现有语音大模型的训练和推理框架,以较低的工程改造成本获得全双工交互能力。
训练方式
我们从已有的语音对话模型出发,构造了包含正常接话和用户打断两类场景的全双工训练数据,让模型学习实时交互中的基本时序行为。
训练分为两个阶段:
● 第一阶段通过监督微调学习多通道交错格式和基本对话状态;
● 第二阶段通过偏好优化进一步调整接话和打断时机,让模型更快、更稳地响应用户输入变化。
监督微调阶段让模型先学会多通道全双工交互格式,并具备基本的接话和打断能力;偏好优化阶段则在此基础上进一步强化时机控制,重点改善何时开始回答、何时停止当前回复。
实验表现
我们在全双工语音问答、接话和打断等场景上评测了 BayLing-Duplex,并与开源全双工语音模型 Moshi 进行比较:
实时语音交互能力
|
模型 |
接话成功率 |
打断成功率 |
回复质量 |
|
Moshi |
71.9% |
81.9% |
2.17 |
|
BayLing-Duplex (SFT) |
88.9% |
91.4% |
3.23 |
|
BayLing-Duplex (+DPO) |
92.0% |
100.0% |
3.39 |
在实时语音交互任务中,仅经过监督微调的 BayLing-Duplex 已经显著优于 Moshi,说明多通道交错建模本身可以赋予模型较强的全双工交互能力。进一步加入偏好优化后,模型的接话和打断时机继续改善,尤其是用户打断后的停止成功率提升到 100.0%。
全双工语音问答
|
模型 |
Llama Questions |
Web Questions |
|
Moshi |
21.0% |
9.2% |
|
BayLing-Duplex (SFT) |
44.3% |
18.0% |
|
BayLing-Duplex (+DPO) |
46.0% |
18.1% |
在全双工语音问答任务中,BayLing-Duplex 也取得了更好的回答准确性;进一步加入 DPO 后,模型在两个数据集上的表现继续提升。
更重要的是,BayLing-Duplex 展示了一种低成本构建全双工语音模型的路径。Moshi 针对全双工交互设计了专门模型结构,并经过约 700 万小时语音数据的大规模预训练;而 BayLing-Duplex 从现有开源语音大模型 GLM-4-Voice 出发,仅使用 400K 全双工构造数据进行微调,就将一个非全双工语音模型转换为原生全双工模型。这意味着,全双工能力不一定需要从头训练专门架构,也可以在已有语音大模型基础上高效构建。
总体来看,BayLing-Duplex 能够在不依赖外部 VAD 决策模块的情况下,实现更自然的实时语音交互。
后续计划
接下来,我们会继续改进模型在真实复杂环境中的鲁棒性,包括噪声、混响、多说话人、口音差异和更自然的多人对话场景。
我们也会持续更新代码、模型和 Demo,欢迎大家试用、反馈和一起探索更自然的语音交互模型。