近年来,大语言模型(LLM)在通用问答与复杂推理任务上表现优异。然而在多语言场景下,LLM 则表现出明显的不均衡:在英语等少数高资源语言上表现优异,在低资源和未见语言上则不稳定或难以支持。
一个直观的解释是训练数据不足,但更本质的问题在于表示空间不匹配。已有研究表明,LLM 已经在统一的语义空间中编码了丰富的跨语言知识,并且在处理多语言文本时会专门“经过”这个统一语义空间(如英语表示空间)。这意味着,LLM 的多语言瓶颈不在缺乏知识,而是难以将已有的知识正确映射到多语言表示空间中。
与此同时,多语言神经机器翻译(NMT)模型在跨语言表示建模方面表现出色。这些 NMT 模型通过 encoder-decoder 架构构建了一个统一的跨语言语义空间,实现上百种语言之间稳定的语义转换。这启发我们:能否将 LLM 的知识处理能力和多语言 NMT 模型的多语言能力组合,实现优势互补?
基于这一思路,中国科学院计算技术研究所 NLP 组开发了多语言扩展大模型 BayLing-MLingual,无需训练大模型便可添加未见语言,并同时增强大模型已有低资源语言和高资源语言能力。BayLing-MLingual一方面利用LLM 由高资源语言带来的通用知识能力,同时结合现有多语言 NMT 模型的多语言理解和生成能力,从而获得多语言通用能力。换言之,将多语言理解和生成外置到外部 NMT 模型,LLM 进行以英文为中心的通用知识处理。
技术报告:https://arxiv.org/abs/2603.17512 代码:https://github.com/BayLing-Models/BayLing-MLingual 模型:https://huggingface.co/BayLing-Models/BayLing-MLingual
该成果已被 ACL 2026 主会接收。
BayLing-MLingual:模型组合的多语言扩展方案
BayLing-MLingual 的核心思想是,将多语言问题转化为表示空间之间的映射问题,并通过模型组合实现跨空间对齐。具体而言,BayLing-MLingual 不再尝试让 LLM 直接学习所有语言,而是在多语言表示空间、LLM 语义推理空间、以及多语言生成空间之间建立稳定映射,从而将多语言能力外置到 NMT 模型,同时保留 LLM 作为知识处理和推理的核心。
1. 模型架构
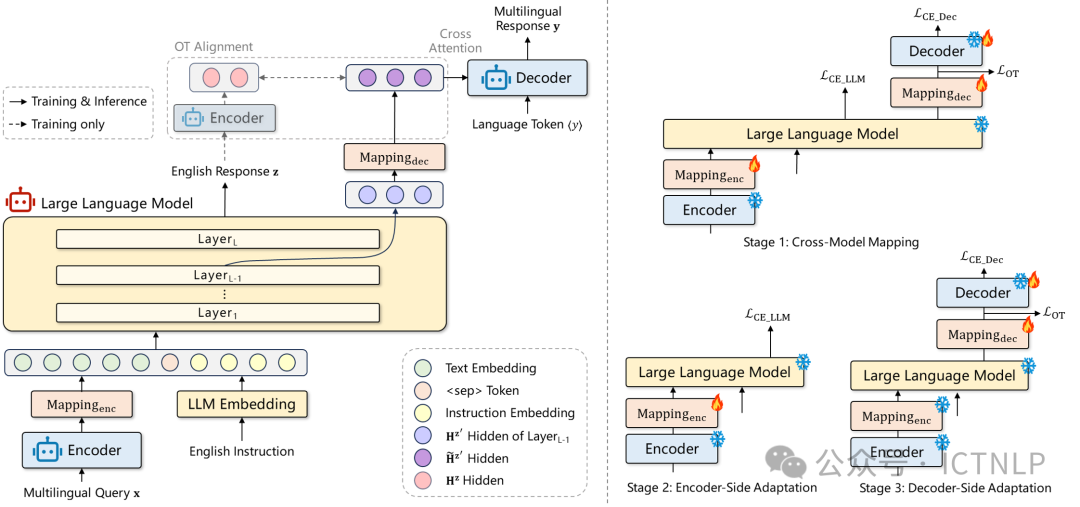
BayLing-MLingual 采用 encoder-LLM-decoder 三段式架构,模块之间用 MLP 架构的轻量映射层连接:
- NMT encoder:将多语言输入映射到共享语义空间。
- LLM:以英语为中心的知识处理和推理核心。
- NMT decoder:生成目标语言输出。
直观来看,多语言输入首先被 encoder 编码成共享语义表示,再由 LLM 进行知识处理和推理,最后 decoder 映射到目标语言输出,实现完整的多语言“理解-处理-生成”闭环。
2. 最优运输对齐
由于不同模型之间的表示空间天然不一致,例如 token 粒度上严重错位,单纯利用线性或非线性变换进行跨模型表示映射难以实现语义一致的转换。为解决这一问题,我们引入最优运输(Optimal Transport, OT)对齐目标,自适应地学习 token 粒度的软匹配,从而在不同长度、不同分词方式的异构表示空间之间建立细粒度的语义对齐关系,实现稳定的语义转换和高质量的多语言生成。
3. 三阶段训练策略
为在不同模型之间建立稳定对齐,BayLing-MLingual 设计三阶段训练策略,LLM 全程无需训练:
- 跨模型对齐阶段:学习 encoder-LLM-decoder 之间的基础语义映射关系。
- 编码器适配阶段:让 LLM 学会利用 encoder 表示完成下游任务。
- 解码器适配阶段:进一步提升 decoder 多语言生成质量。
分阶段的训练设计能够有效避免不同优化目标之间的冲突,使模型能够逐步建立稳定的跨模型映射,并适配下游任务。
实验结果:多语言能力可以被“外挂式”加载
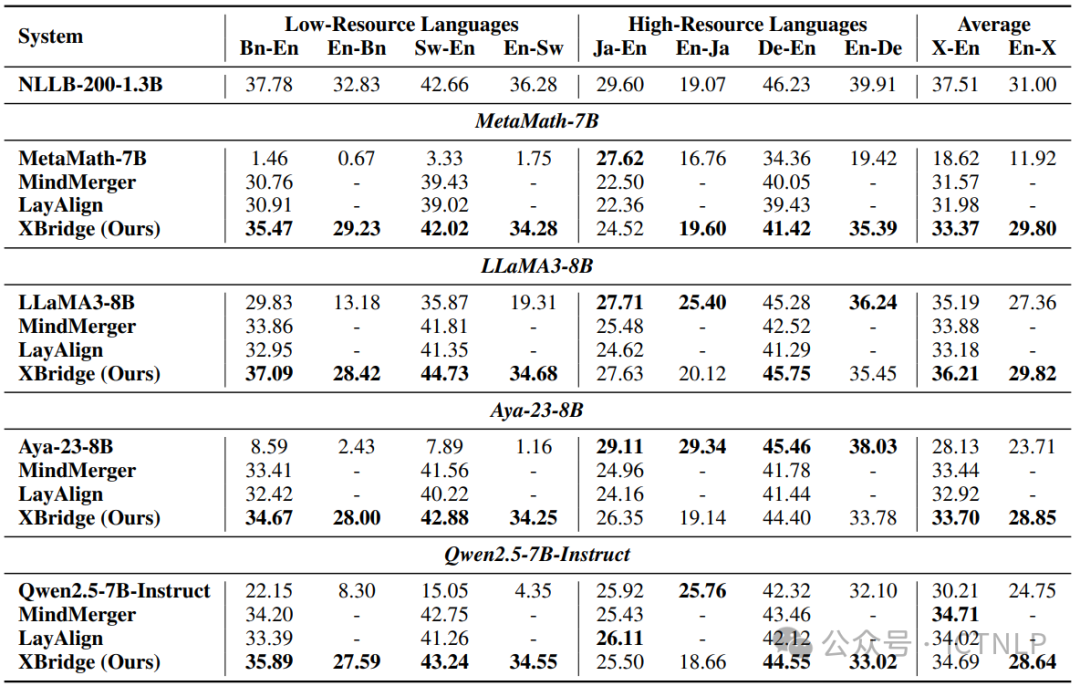
我们首先在 10 种语言设置下构建 XBridge 作为前置验证框架,用于验证多语言能力是否可以通过外部模型进行“外挂式”加载,以及验证跨模型对齐方法的有效性。
1. 多语言能力成功外置到 NMT 模型
我们在 FLORES-101 翻译任务的 10 种语言子集上评估模型的跨语言理解与生成能力。XBridge 显著提升了 LLM 在低资源语言甚至未见语言(如孟加拉语、斯瓦西里语等)上的理解和生成能力,性能提升 +15~30 BLEU,达到接近 NMT 工业级可用水平(NLLB)。这表明 LLM 的多语言能力是可以外置到外部 NMT 模型的。
2. 下游任务显著提升推理和生成能力
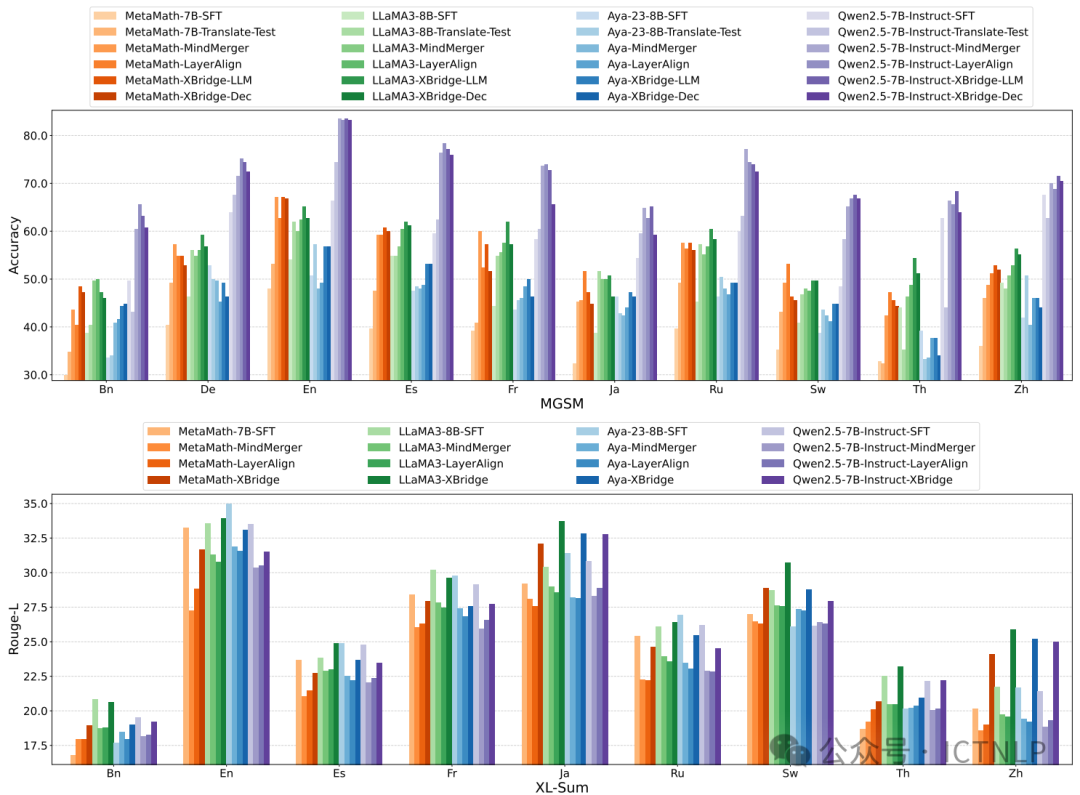
我们进一步在两个典型的多语言任务上验证 XBridge 对真实任务的影响,包括:多语言数学推理任务(MGSM)和摘要生成任务(XL-Sum)。XBridge 显著缩小高资源、低资源语言之间性能差距,推理准确率差距平均降低到 8% 以内,摘要生成质量差距缩小到约 4 个 Rouge-L 点以内。此外,XBridge 在低资源语言上获得显著提升的同时,保持或提升了高资源语言性能。值得注意的是,这个过程不需要训练 LLM。
3. 可泛化、语言无关的跨模型映射
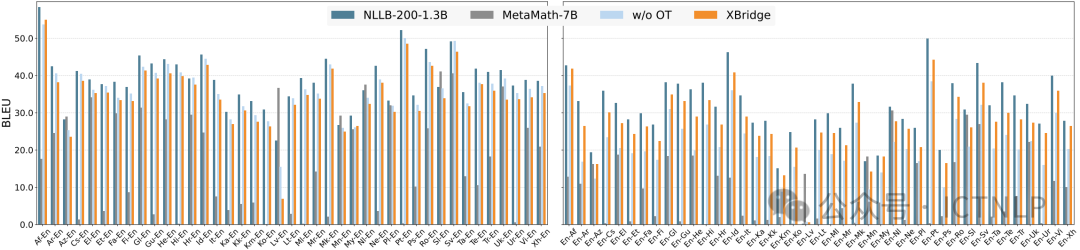
我们直接在 FLORES-101 翻译任务上测试 41 种未参与训练的语言,评估 XBridge 的零样本泛化能力。相比原始 LLM 在大量语言上不具备语言能力,XBridge 平均提升 +18 BLEU,多数语言的理解和生成质量直接达到可用级别,性能甚至接近外置的工业级 NMT 模型(NLLB)。这表明 XBridge 学到的是一种语言无关的跨模型映射。
BayLing-MLingual:不训练 LLM 即可支持 2500 个跨语言方向自由问答
基于 XBridge 在 10 种语言设置下验证得到的语言无关映射能力,我们进一步扩展语言范围,在 50 种语言的通用指令遵循数据上训练构建 BayLing-MLingual。
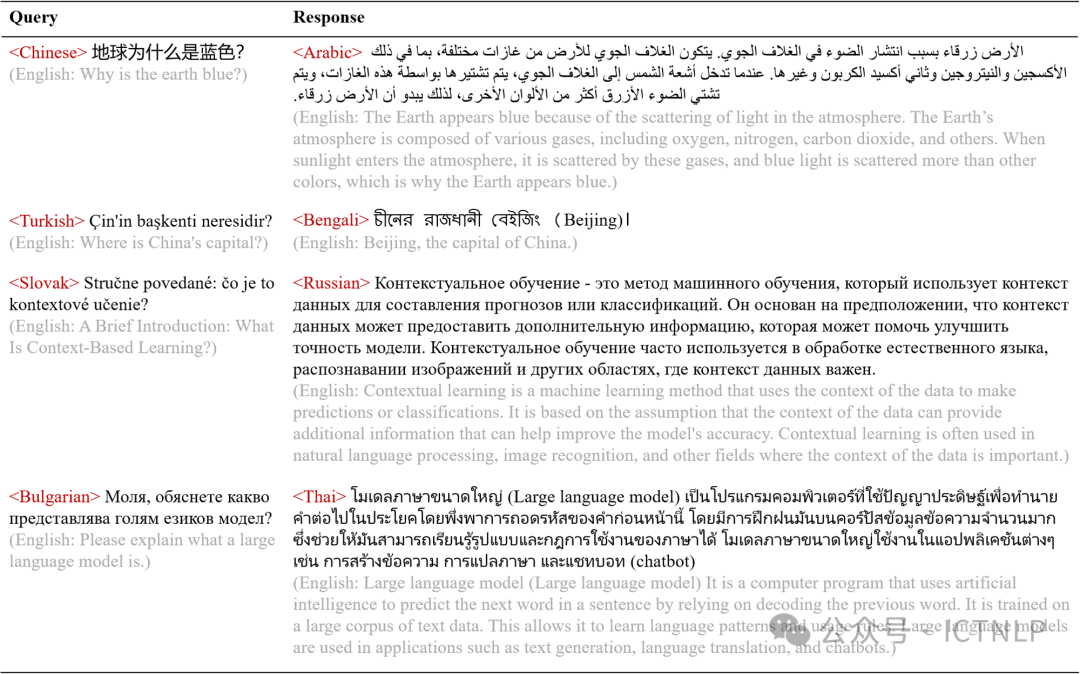
BayLing-MLingual 是一个支持 50 种语言的多语言问答模型。用户可以使用任意支持语言提问,并自由指定回答语言,从而实现 2500 种跨语言交互组合。以下是一个跨语言问答示例。
总结与展望
通过将多语言能力外置到外部 NMT 模型,BayLing-MLingual 在不训练 LLM 的前提下,实现了对低资源和未见语言的高质量支持。除了性能的提升,BayLing-MLingual 更重要的价值在于为 LLM 的多语言扩展提供了一个新思路:扩展 LLM 的多语言能力,或许不再需要依赖大规模、高质量、多任务的多语言训练数据,而是可以通过组合现有模型,实现低成本扩展。