2026年8月,自然语言处理团队2篇论文被EMNLP 2026主会录用。EMNLP的全称是Conference on Empirical Methods in Natural Language Processing,每年举办一次,是自然语言处理领域公认的三大顶级国际会议之一。此次会议将于2026年10月24日到29日在匈牙利布达佩斯召开。1. Learning to Remember: End-to-End Training of Memory Agents for Long-Context Reasoning
录用类型: EMNLP 2026 Main Conference
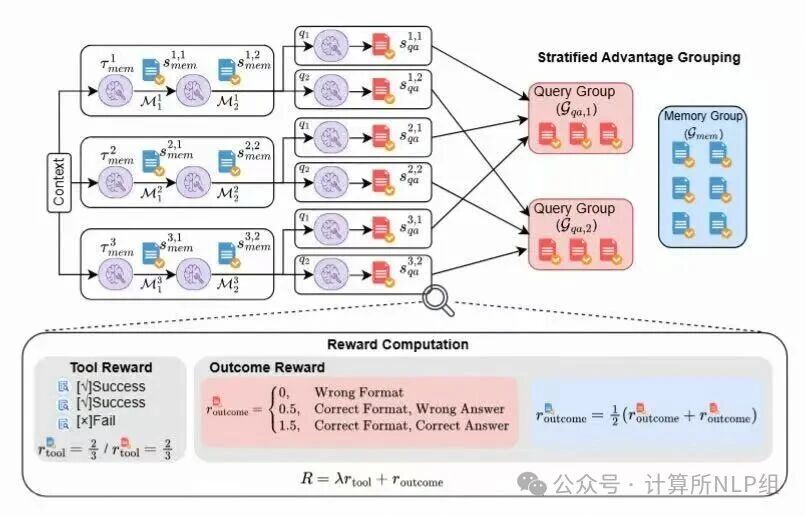
简介:随着大语言模型上下文窗口不断扩展,模型能够读取更长的文本,但面对持续到来的对话、日志和事实更新,仅依赖长上下文或查询时检索仍难以稳定维护动态状态,也会在回答多个问题时重复处理相同材料。本文提出统一记忆智能体(Unified Memory Agent,UMA)。UMA 在未来问题尚未出现时,先通过增、删、改、查操作将信息整理为结构化记忆库;问题到来后,再结合记忆库与原始上下文检索完成回答。同一份记忆可以被多个问答会话重复使用,从而形成“一次构建、多次使用”的记忆模式。为联合训练记忆维护与问题回答,本文设计了 Task-Stratified GRPO。该方法利用共享记忆所支持的多个下游问答结果监督上游记忆构建,并分别归一化记忆轨迹和不同问题的问答轨迹,使训练信号与一对多的任务结构保持一致。本文还构建了 Ledger-QA,用于评估智能体在长期交互中跟踪消费记录、累计金额和状态更新的能力。实验覆盖 13 个测试时学习与准确检索基准。UMA-Generalist 在综合评测中表现出良好的跨任务泛化能力,UMA-Specialist 则进一步提升了 Ledger-QA 上的长期状态跟踪效果。研究结果表明,主动、结构化且可学习的记忆管理能够有效补充长上下文和传统检索机制。2. StreamUni: Achieving Streaming Speech Translation with a Unified Large Speech-Language Model
录用类型: EMNLP 2026 Main Conference
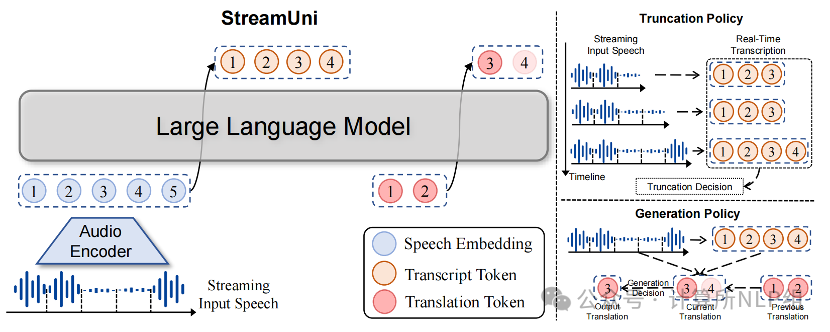
简介:流式语音翻译(StreamST)需要在持续接收源语音输入的同时,确定生成译文的适当时机,即制定生成策略,从而在低延迟与高翻译质量之间取得平衡。现有流式语音翻译方法通常针对句子级语音片段运行,这类任务被称为同声语音翻译(SimulST)。在实际应用中,它们需要与上游分割模型协同工作才能实现流式语音翻译;经过截断的语音片段会限制SimulST模型,使其只能基于上游模型预先设定的上下文信息作出策略决策并生成译文。此外,由于语音输入和跨语言生成较为复杂,SimulST模型难以学习有效的策略。为解决这些问题,我们提出StreamUni,通过统一的大型语音语言模型(LSLM)实现流式语音翻译。具体而言,StreamUni引入语音思维链(CoT),引导LSLM生成多阶段输出。借助这些多阶段输出,StreamUni能够同时完成语音分割、策略决策和译文生成。此外,我们提出一种流式思维链训练方法,利用有限的CoT数据增强模型在低延迟条件下的策略决策与生成能力。实验表明,我们的方法在SimulST和StreamST任务上均取得了当前最优性能。